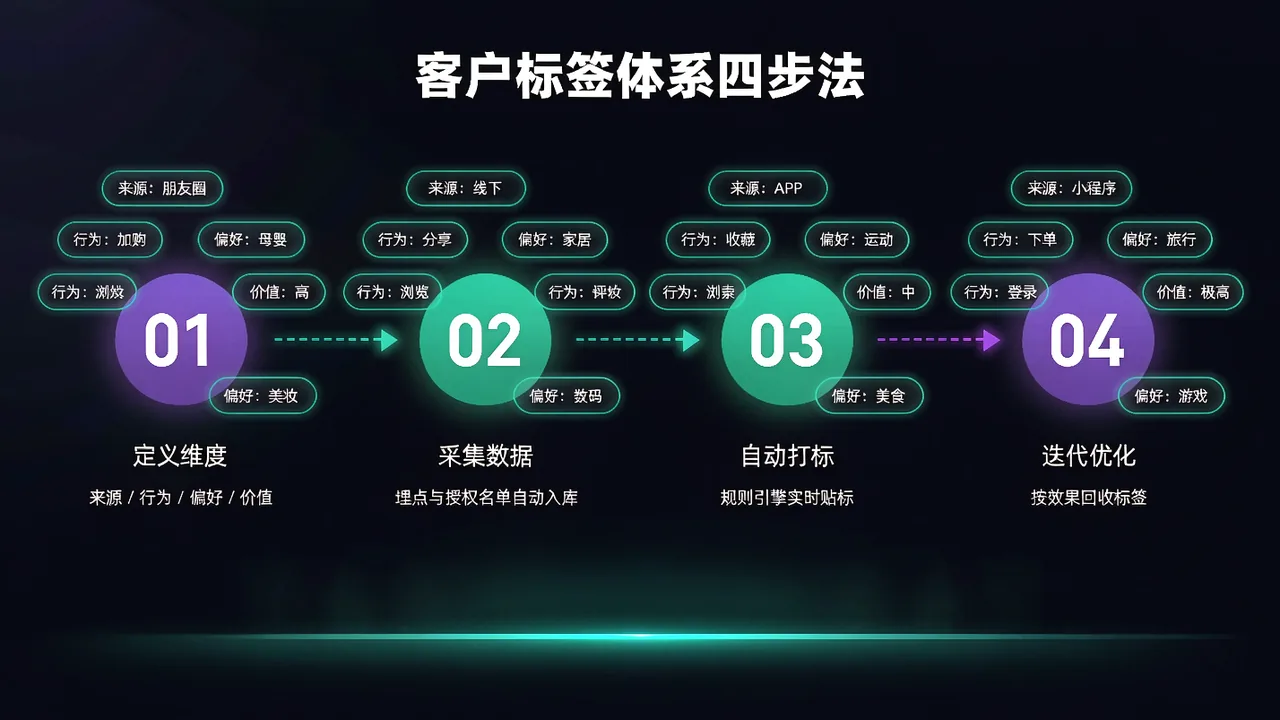
客户标签体系是精细化运营的地基。没有标签,运营往往退化成无差别群发;有了标签,才有可能做到精准触达。但搭建标签体系这件事,失败案例多数不是因为工具不行,而是因为目标没定、口径不清、没人维护。下面给出一套四步落地的框架,并附上口径示例与自查清单。
一套能长期使用的标签体系通常具备三个特征:字段数量不多但都能被用到;每个标签都有明确的责任人与更新周期;一线在执行时不需要额外解释就能理解标签含义。反过来,字段成百上千却无人取用的体系,维护成本高,还会干扰判断。
目标先于标签:先回答三个问题
标签不是越多越好,它的价值取决于能否服务于运营目标。动手设计之前,先回答三个问题:这套标签要用在什么动作上,是复购促进、流失挽回还是转化提效;哪些动作必须自动化触发;谁来维护口径,多久复核一次。三个问题答不上来,标签建完大概率会闲置。
不同目标决定了体系侧重点。以提升复购为目标,行为与偏好维度的权重要高;以降低流失为目标,沉默时长与互动频次是核心字段;以提高转化率为目标,则需要更细的来源与意向字段。
回答这三个问题时,建议把答案写成一页纸的说明文档,包含目标指标、标签清单与责任人三部分。文档不需要复杂,价值在于当团队里有人提出「再加一个标签」时,可以先对照目标判断它是否必要,避免体系无限膨胀。
还有一个常被忽略的约束是采集成本。有些字段听起来有价值,但需要客户主动填写或员工逐条补充,执行成本高、准确率低。判断标准很直接:如果某个字段两周内没人更新,它就不该继续留在体系里。
四个常用标签维度
- 来源维度:记录客户从哪里来,例如朋友圈投放、视频号投放、活动报名、老客转介绍,用于评估各渠道的获客质量与后续贡献。
- 属性维度:记录基本属性,例如性别、年龄区间、所在城市、职业分布,用于粗粒度的人群划分与内容适配。
- 行为维度:记录互动情况,例如近三十天是否购买、是否浏览过某品类、是否领取过优惠券、是否参与过活动,这类字段对运营节奏的指导价值较高。
- 偏好维度:记录兴趣倾向,例如偏好新品、价格敏感、关注某类产品,用于个性化推荐与内容排序。
维度不是并列堆砌。实践中常见做法是以行为维度为主线,用属性与偏好做补充条件,用来源维度做效果归因。这样标签数量可控,也不至于互相矛盾。
每个维度在细化时都有容易忽略的地方。来源维度建议保留具体渠道名称而不是笼统归类,例如区分不同投放计划而不是只写「广告」;属性维度要注意时效,年龄区间与所在城市会变化,需要标注采集时间;行为维度的观察窗口必须写清,近三十天与近七天代表完全不同的含义;偏好维度的判断依据应当可追溯,基于购买记录还是基于浏览行为,得到的结论可能相反。
标签规则怎么写才不打架
每个标签都要有明确定义,否则同一个人在不同报表里可能被算成两类客户。规则要写清四件事:判定字段是什么、阈值取多少、观察窗口多长、由谁更新。
以高价值客户为例,需要明确是累计消费满一定金额,还是近三十天有购买且客单价高于某条线;是终身累计还是滚动窗口;达到条件后是否会自动退出。规则越清晰,标签越准确,也越容易被不同团队复用。
还要约定冲突消解顺序。一个客户同时满足沉默客户与高价值客户时,应该以哪一类优先,这条规则如果不提前写死,系统执行的顺序就会决定结果。
规则的表达方式同样影响执行。尽量使用系统可以直接判断的条件,例如「累计消费金额达到某数值且最近一次购买在三十天内」,避免「消费能力较强」「比较活跃」这类需要人工解读的描述。凡是需要主观判断的标签,不同的人给出的结果就会不一致,长期来看会削弱数据的可信度。
自动打标与分层怎么跑起来
标签的价值在于自动化。借助霸网智投这样的平台,可以按预设规则自动给客户打标签并完成分层,减少人工整理成本。常见的自动触发场景有两类:条件触发,例如累计消费达到阈值时自动标记为高价值并归入专属分层;时间触发,例如客户长时间未互动自动标记为沉默客户,并进入召回流程。
自动化跑起来之前,建议先用小样本验证规则。挑一百名左右客户,人工核对系统打标结果与业务判断是否一致,确认无误后再放开全量,避免错误规则批量污染标签。
运行一段时间后,还应做一次反向检查:随机抽取一批客户,看他们身上的标签与企业对该客户的真实了解是否吻合。发现偏差时,先判断是阈值设错,还是数据源本身不完整。经验上看,多数偏差来自数据源缺漏,而不是规则逻辑写错。
零售行业分层示例与口径
- 新客:首次消费后三十天内。运营重点是完成二次触达,建立使用或复购习惯。
- 活跃客:近三十天有购买行为。运营重点是提高购买频次与连带品类。
- 忠诚客:累计消费满三次,或连续多个周期保持购买。运营重点是会员权益与转介绍。
- 流失预警客:超过六十天未互动且未来店记录。运营重点是分层召回,先了解原因再给激励。
这四层的阈值只是起点,真正落地时要按客单价与购买周期调整。购买周期长的品类,六十天的阈值明显偏短,需要拉长观察窗口。
阈值设定还有一个实用原则:分层之间的人数分布不宜严重失衡。如果某一层占到八成以上,这一层就失去了筛选意义,需要重新调整阈值或增加分层。比较健康的分布通常呈现两头小、中间大的形态,便于针对不同群体分别设计动作。
标签体系会老化:迭代机制
标签体系不是一次建成的。业务换了主推品类、渠道结构变化、客户结构老化,都会让原有口径失真。建议按月做一次体检,看三个信号:某个标签覆盖的人数是否异常膨胀或萎缩、分层之间的转化路径是否还成立、是否存在长期未被动用过的字段。
发现失真的处理方式有两种:调整阈值,或直接停用并归档该标签。宁可少而准,也不要保留一批无人使用、无人维护的字段,它们会干扰一线判断。
标签与分层常见的五类问题
- 只打不更新:标签停留在客户初次进入时的状态,后续行为没有回写,分层与实际逐渐脱节。修正办法是为关键标签设定固定的更新触发条件。
- 口径多套并行:投放团队与运营团队各自维护一套分层标准,数据对不上。修正办法是统一口径并指定单一维护人。
- 标签与动作脱节:标签打好了却没有对应的运营动作,最终沦为报表字段。修正办法是每个标签在上线前先约定它触发什么动作。
- 过度依赖单一维度:只看消费金额分层,忽略互动情况,容易把高潜力客户误判为低价值。修正办法是至少组合两个维度判断。
- 缺少退出机制:客户状态变化后仍留在原分层,长期积累造成整体失真。修正办法是为每一层设定明确的退出条件。
搭建顺序自查清单
- 运营目标是否可以用一到两个指标描述清楚。
- 每个标签是否有字段、阈值、窗口期与责任人。
- 冲突时的优先级是否已经写进规则。
- 自动触发是否经过小样本验证。
- 是否约定了月度复核与停用机制。
体系建成之后,衡量它是否有效的方法也很简单:一线在触达前是否真的会去看标签,管理者做决策时是否会引用分层数据。如果两个答案都是否定的,说明标签与实际运营之间还缺一段连接,需要回到动作定义那一步重新对齐。
搭建客户标签体系,本质上是把客户运营的思考方式结构化。想清楚运营目标,再设计标签,标签才会真正服务于增长;反过来先堆字段,最终只会得到一份好看的名单。若需要了解标签如何接入自动化流程,可参考客户生命周期运营方法论一文。